如何使用Hystrix实现服务请求隔离?
保留所有版权,请引用而不是转载本文(原文地址 https://yeecode.top/blog/130/ )。
概述
在串联连接的模块中,如果一个模块失效,则它的前置模块因为无法获取后置模块的服务,也会失效。因此,失效会在串联的模块中向前蔓延。
假设系统中节点N1会调用节点N2、N3、N4三个节点提供的不同服务,如图所示。
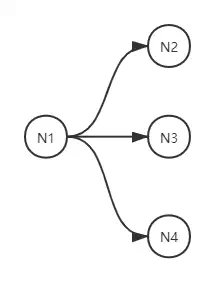
在不考虑隔离的情况下,节点N1的工作过程通常如伪下面代码所示。
public Result service(Request request) {
    Result result = new Result();
    result.append(n2.service(request));
    result.append(n3.service(request));
    result.append(n4.service(request));
    return result;
}
当节点N2失效时,n2.service(request)操作将会阻塞,从而导致节点N1中的service操作会被阻塞。于是,大量的请求拥塞在节点N1上,使得节点N1的并发线程数急剧升高,最终导致节点N1内存耗尽而失效。
有一种措施可以避免失效的蔓延,那就是隔离。
我们可以使用线程池将节点N1和后方的节点N2、N3、N4隔离起来。具体措施是在N1中为调用节点N2、N3、N4的操作各设立一个线程池,每次需要调用它们的服务时,从线程池中取出一个线程操作,而不是使用N1节点的主线程操作。实现流程的伪代码如下。
public Result service(Request request) {
    Result result = new Result();

    // 从调用N2节点的专用线程池中取出一个线程
    Thread n2ServiceThread = n2ServiceThreadPool.get();
    if (n2ServiceThread != null) {
        // 使用获得的线程调用N2节点的服务
        n2ServiceThread.start();
        // 获得N2节点给出的结果,并汇总入N1节点的处理流程中
        result.append(n2ServiceThread.get());
    }

    // 省略对N3、N4节点的调用流程

    return result;
}
这样,当N2节点失效时,会使得N1节点中的调用线程阻塞,进而导致N1节点中操作N2节点的线程池被占满。之后,这一结果不会再继续扩散,不会对其他线程池造成影响,从而保证节点N1的资源不会被耗尽。
这种操作将N2节点失效引发的影响隔离在了节点N1的一个线程池中,提升了节点N1的稳定性。
环境配置
通过Hystrix就可以方便地实现这一操作。接下来,我们给出简单的示例。
首先,准备SpringBoot项目,然后在其中引入适用于SpringBoot的hystrix包:
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-netflix-hystrix</artifactId>
    <version>2.2.7.RELEASE</version>
</dependency>
注意,如果这时候启动提示如下的错误,则基本是SpringBoot版本与hystrix版本不匹配导致的。因为hystrix是基于SpringCloud的,而SpringCloud和SpringBoot存在版本对应关系。如果对应不一致,则可能导致出现下面的错误。
java.lang.NoSuchMethodError: 'void org.springframework.boot.builder.SpringApplicationBuilder.<init>(java.lang.Object[])'
这里我们给出一个可用的对应版本,即SpringBoot的2.3.5.RELEASE和spring-cloud-starter-netflix-hystrix的2.2.7.RELEASE。它们这一对是肯定没有问题的。
然后,我们需要在SpringBoot的主类上增加@EnableHystrix注解,以启用Hystrix。如下所示。
@SpringBootApplication
@EnableHystrix
public class DemoApplication {
    public static void main(String[] args) {
        SpringApplication.run(DemoApplication.class, args);
    }
}
环境配置就是这么简单,接下来我们就可以写业务代码了。
功能实现
我们编写三个查询方法,分别查询用户名、年龄、位置,对每个方法都设置500ms的超时时间,如下所示。
@HystrixCommand(
        commandKey = "IsolationService_queryUserNameById",
        fallbackMethod = "fallBackForName",
        commandProperties = {
                // 超时判定时间设置为500ms
                @HystrixProperty(name = HystrixPropertiesManager.EXECUTION_ISOLATION_THREAD_TIMEOUT_IN_MILLISECONDS, value = "500"),
        }
)
String queryUserNameById(int i) {
    System.out.println("正在查询用户名,用户编号为" + i);
    return "易哥";
}

@HystrixCommand(fallbackMethod = "fallBackForAge",
        commandProperties = {
                // 超时判定时间设置为500ms
                @HystrixProperty(name = HystrixPropertiesManager.EXECUTION_ISOLATION_THREAD_TIMEOUT_IN_MILLISECONDS, value = "500"),
        }
)
String queryUserAgeById(int i) {
    System.out.println("正在查询用户年龄,用户编号为" + i);
    return "18";
}

@HystrixCommand(fallbackMethod = "fallBackForLocation",
        commandProperties = {
                // 超时判定时间设置为500ms
                @HystrixProperty(name = HystrixPropertiesManager.EXECUTION_ISOLATION_THREAD_TIMEOUT_IN_MILLISECONDS, value = "500"),
        }
)
String queryUserLocationById(int i) throws InterruptedException {
    // 故意延时,模拟堵塞
    Thread.sleep(1000);
    System.out.println("正在查询用户位置,用户编号为" + i);
    return "西子湖畔";
}
同时,我们也为上述方法指定备用方法,如下所示。以便于上述方法发生错误时调用。
String fallBackForName(int i) {
    System.out.print("生成默认用户名信息,用户编号为" + i);
    return "平台用户";
}

String fallBackForAge(int i) {
    System.out.print("生成默认年龄信息,用户编号为" + i);
    return "年富力强";
}

String fallBackForLocation(int i) {
    System.out.print("生成默认位置信息,用户编号为" + i);
    return "太阳系";
}
然后,我们使用如下的代码上述三个方法。
/**
 * 演示Hystrix的隔离功能
 * 该方法会同时调用三个不同的目标方法
 *
 * @return 3个目标方法返回值的拼接结果
 * @throws Exception 运行中发生的异常
 */
@RequestMapping("/isolation")
public String isolation() throws Exception {
    return "姓名:" + isolationService.queryUserNameById(1) + "\r\n" +
            "年龄:" +isolationService.queryUserAgeById(1) + "\r\n" +
            "位置:" +isolationService.queryUserLocationById(1) + "\r\n";
}
可以在控制台上得到如下输出:
正在查询用户名,用户编号为1
正在查询用户年龄,用户编号为1
生成默认位置信息,用户编号为1
可见,对于存在延时的queryUserLocationById方法,会触发备用方法的调用,进而最终得到如下的返回值:
姓名:易哥
年龄:18
位置:太阳系
整个返回过程很快,并不需要5秒的等待。即上游调用方并没有受到queryUserLocationById的5秒延迟的影响。
通过以上操作,就验证了Hystrix的隔离功能。
隔离策略
关于隔离,大家常疑惑的点在于隔离策略的选择。这里我主要是摘抄参考了《高性能架构之道(第二版)》这本书,如果要细致学习的话,十分建议大家去看下这本书。
线程隔离需要将请求放入到线程中执行,因此比信号量隔离占用资源更多,这一点很好理解。大家疑惑点主要是原方法发生超时后,两种隔离策略的表现有何不同。下面我们来着重介绍。
只要使用了线程池,Hystrix就可以判断原方法的执行超时,并在原方法执行超时后,不等待原方法全部执行完毕而直接启用备用线程。在这个过程中,我们还可以通过Hystrix的execution.isolation.thread.interruptOnTimeout配置来决定是直接中断原方法还是继续执行原方法中的后续内容(但是返回值不会被采用,因为已经采用了备用方法的返回值)。这点,在书中有示例介绍。
那如果使用信号量,原方法将还备用方法在一个线程中运行,那首先面临的第一个问题是:Hystrix还能够识别出原方法的超时么?
答案是肯定的。Hystrix依旧可以判断出原方法执行超时,并调用备用方法,最终也会采用备用方法的返回值。
那Hystrix能够在原方法执行超时后,立刻调用备用方法,即做到快速失败么?
答案是否定的。因为备用方法的执行也要使用原方法的线程,因此必须要等原方法执行结束后,备用方法才可执行。也正因为如此,虽然信号量隔离能够识别超时,但因为不能快速失败,所以意义不大。
我们可以使用下面的代码验证上述结论。示例中,两个原方法的执行时间都为5000ms,超时时间均设置为50ms,分别采用线程隔离模式和信号量隔离模式。
@HystrixCommand(
        fallbackMethod = "fallBackForQueryUserNameById",
        commandProperties = {
                // 采用线程隔离模式
                @HystrixProperty(name = HystrixPropertiesManager.EXECUTION_ISOLATION_STRATEGY, value = "THREAD"),
                // 超时判定时间设置为30ms
                @HystrixProperty(name = HystrixPropertiesManager.EXECUTION_ISOLATION_THREAD_TIMEOUT_IN_MILLISECONDS, value = "50"),
        }
)
String queryUserNameByIdWithThread(int i) throws InterruptedException {
    System.out.println("正在使用线程模式查询用户名,用户编号为" + i);
    Thread.sleep(5000);
    return "易哥" + i;
}

@HystrixCommand(
        fallbackMethod = "fallBackForQueryUserNameById",
        commandProperties = {
                // 采用信号量隔离模式
                @HystrixProperty(name = HystrixPropertiesManager.EXECUTION_ISOLATION_STRATEGY, value = "SEMAPHORE"),
                // 超时判定时间设置为30ms
                @HystrixProperty(name = HystrixPropertiesManager.EXECUTION_ISOLATION_THREAD_TIMEOUT_IN_MILLISECONDS, value = "50"),
        }
)
String queryUserNameByIdWithSemaphore(int i) throws InterruptedException {
    System.out.println("正在使用信号量模式查询用户名,用户编号为" + i);
    Thread.sleep(5000);
    return "易哥" + i;
}

String fallBackForQueryUserNameById(int i) {
    return "平台用户" + i;
}
通过外部调用依次触发上述两个原方法5次,并记录每次的响应时间,可以得到下面的结果。
平台用户1 (+61ms)
平台用户2 (+61ms)
平台用户3 (+63ms)
平台用户4 (+61ms)
平台用户5 (+61ms)
平台用户1 (+5003ms)
平台用户2 (+5004ms)
平台用户3 (+5005ms)
平台用户4 (+5012ms)
平台用户5 (+5000ms)
可见两种隔离方式在原方法执行超时后,都会启用备用方法。但只有采用线程隔离的方式,才能做到快速失败。
参数详解
以上实现的是最简单的隔离示例,也仅仅使用了最简单的参数,而其他参数都是用的默认值。但是这个作为示例是可以的,真正使用时,大家还是要对Hystrix的各个参数有详细的了解,至少也要知道大体的含义和默认值。否则,后续使用中,可能会遇到不少百思不得其解的地方。
总之,Hystrix要比这个强大的多。大家还是要好好学一下。
下面是我对@HystrixCommand参数的介绍,主要是摘抄参考了《高性能架构之道(第二版)》这本书。上面的示例也是参考的书里的。下面的参数我这里列的不是很全,如果要细致学习的话,十分建议大家去看下这本书。
HystrixCommand的主要参数如下:
- groupKey 组名。通过为命令指定一个组名,我们就可以将多个指令分到同一个组中。这样,我们可以使用配置文件为该组设置参数,而不用在每个指令中一一设定参数。通过组名,我们也可以对指标汇总分类。默认为该注解所处类的类名。
- commandKey 指令名。用来唯一指定一个指令。这样,我们可以使用配置文件为某个指令设置参数,也可以在指标展示时知道指标具体来自哪个指令。默认为该注解所在的方法的方法名。如果程序中注解所在方法的名字不是唯一的,那强烈建议通过commandKey指定一个唯一的名字,以防止多个指令间配置信息的互相干扰。
- fallbackMethod 备用方法名。用来指定该方法的备用方法,当该方法发生错误或超时时,将执行该备用方法。注意,备用方法必须和该方法有相同的入参类型和返回值类型。
- commandProperties 命令参数。在这里可以为该指令设置多个命令参数。具体命令参数的介绍详见书中的命令参数小节。
- ignoreExceptions 要忽略的异常。通常,当原方法执行抛出异常时,Hystrix会自动帮我们调用备用方法。通过该参数指定一些异常,就可以让Hystrix遇到这些异常时,将它们抛出而不触发备用方法。
- raiseHystrixExceptions 异常包装设置。该配置只有两个选项,要么为空,要么填写RUNTIME_EXCEPTION。如果填写RUNTIME_EXCEPTION,那原方法执行中抛出的所有未被忽略(参见ignoreExceptions配置)的异常会被包装进HystrixRuntimeException中抛出。因为有些场景下,外部调用方需要捕获的异常的类型是相同的,以便于处理。默认值为空,这种情况下原方法的异常会被正常抛出而不被包装。
- defaultFallback 默认备用方法。它比备用方法(参见fallbackMethod配置)的优先级更低,因此只在没有配置备用方法的时候生效。默认备用方法不允许有入参,且返回值类型必须要和原方法一致。
其中,执行器参数如下;
- execution.isolation.strategy 隔离策略,有以下两种策略,默认值为THREAD。
- THREAD:每次调用都会启用线程池中的独立线程,并发请求数目受线程池中线程数的限制。
- SEMAPHORE: 调用会在原线程上执行,并发请求数目受信号量计数的限制,
线程隔离策略支持超时后的快速失败,即当原方法延迟过大时会直接失败或调用备用方法返回,而不需要等原方法全部执行完毕。当原方法中存在网络调用等容易引发超时的操作时,最好使用THREAD隔离策略。不过,相比于SEMAPHORE策略,其开销略大,因为SEMAPHORE不需要创建额外的线程。
- execution.timeout.enabled 是否启用超时。如果设置为true,则会在原方法执行超时时启用备用方法。默认值为true。
- execution.isolation.semaphore.maxConcurrentRequests 在使用SEMAPHORE策略时,该参数用来设置允许请求的最大数值。超过该数值的调用将被拒绝。默认值为10。
- execution.isolation.thread.timeoutInMilliseconds 在启用超时的情况下,该参数用来设置超时时间的毫秒数。若原方法执行超过该时间,将执行备用方法。默认值1000。该参数对于THREAD和SEMAPHORE两种隔离策略均有效。THREAD策略因为使用独立的线程,可以实现在超时后快速失败或者调用备用方法返回。而SEMAPHORE策略因为使用的是调用方的线程,必须要等原方法执行完成,无法做到快速失败。
- execution.isolation.thread.interruptOnTimeout 在使用THREAD策略时,设置当原方法执行超时后,是中断原方法还是继续执行原方法中的后续内容。默认为true,即中断原方法。
- execution.isolation.thread.interruptOnCancel 在使用THREAD策略时,设置当原方法被取消后,是中断原方法还是继续执行原方法中的后续内容。默认为false,即继续执行原方法中的后续内容。
OK,以上就是Hystrix实现请求隔离的示例。